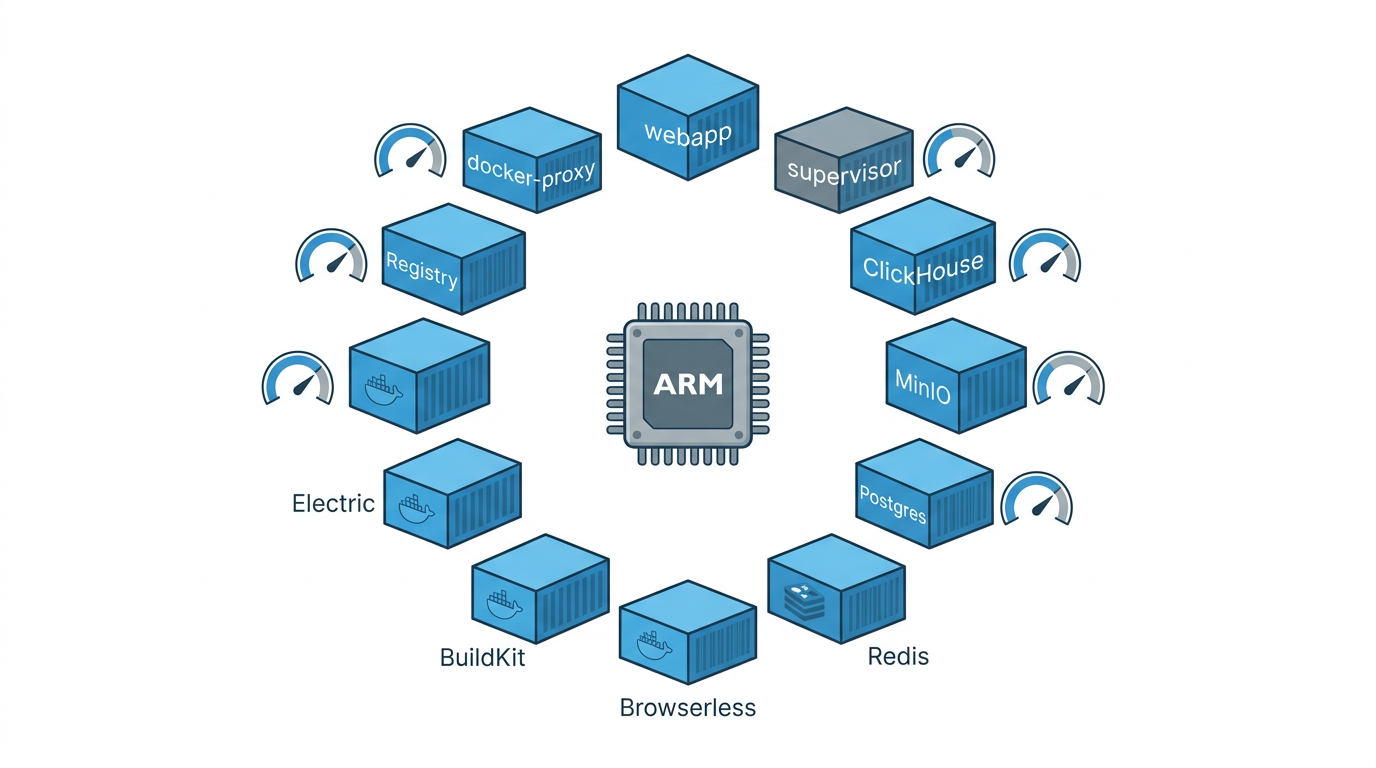
Poprzedni wpis z tej serii opisywał pipeline automatyzujący bloga. Trigger.dev napędza dużą część tego pipeline’u. Obsługuje też checker do marzeń o terminie na prawo jazdy z rozwiązywaniem CAPTCHA, synchronizację danych z paneli słonecznych, demona ServiceNow i kilkanaście innych tasków. Wszystko na jednej płytce ARM64, która jednocześnie hostuje n8n, serwer Samba, Ollama, AdGuard Home i runner GitHub Actions.
Ten wpis opisuje, jak to działa, ile kosztuje w RAM i gdzie się sypie.
Sprzęt
6-rdzeniowy ARMv8, 7,4 GB RAM, 916 GB NVMe. Ubuntu 22.04.5 LTS, Docker 29.0.2. Płytka pobiera około 10W w idle i mieści się w kącie półki. Używam jej jako serwera homelab od jakiegoś czasu. Więcej szczegółów jest w poście o moim setupie z Claude Code.
Kluczowy fakt dla tego wpisu: to ARM64 (aarch64), a dokumentacja Trigger.dev niewiele mówi o obsłudze ARM. Obrazy są multi-arch. Działa. Ale tuning jest inny niż na maszynie x86 z 32 GB RAM.
Co tak naprawdę uruchamia Trigger.dev v4
Jedenaście kontenerów. Oto ile każdy z nich kosztuje w RAM w stanie stabilnym:
| Kontener | Obraz | RAM |
|---|---|---|
| webapp | triggerdotdev/trigger.dev:v4-beta | 780 MB |
| supervisor | triggerdotdev/supervisor:v4-beta | 109 MB |
| clickhouse | bitnamilegacy/clickhouse | 1,27 GB |
| minio | bitnamilegacy/minio | 234 MB |
| postgres | postgres:14 | 121 MB |
| browserless | ghcr.io/browserless/chromium | 287 MB |
| buildx buildkit | moby/buildkit | 121 MB |
| electric | electricsql/electric:1.2.4 | 79 MB |
| registry | registry:2 | 12 MB |
| docker-proxy | tecnativa/docker-socket-proxy | 6 MB |
| redis | redis:7 | 14 MB |
Łącznie: około 3 GB. Na maszynie, która hostuje też wszystko inne, to większość dostępnego RAM. Jest ciasno.
Dwie rzeczy mają największe znaczenie: ClickHouse z 1,27 GB i webapp z 780 MB. Reszta jest do opanowania.
ClickHouse na maszynie z ograniczoną pamięcią
ClickHouse to magazyn historii uruchomień i metryk. Domyślnie konfiguruje się pod serwer z dużą ilością RAM. Na 7,4 GB maszynie z kilkunastoma serwisami słowo “dużo” jest względne.
Skończyłem na takich ustawieniach:
| |
Najbardziej wpływowe ustawienia to max_server_memory_usage_to_ram_ratio (0.15 ogranicza ClickHouse do około 1,1 GB) i wyłączenie równoległego parsowania i formatowania. Gdy równoległe przetwarzanie jest włączone, ClickHouse chętnie tworzy wątki aż do momentu, gdy OOM killer kończy dyskusję.
Obraz Bitnami (bitnamilegacy/clickhouse) działa na ARM64. Oficjalny obraz ClickHouse też działa, ale struktura konfiguracji Bitnami jest łatwiejsza do nadpisania przez wolumeny Docker.
Sterta Node.js dla webappu
Kontener webapp to aplikacja Node.js. Bez jawnej konfiguracji domyślny limit sterty Node.js wynosi około 512 MB, co wystarczy, żeby webapp padł pod obciążeniem. Ta zmienna środowiskowa to naprawia:
| |
3 GB może wyglądać hojnie dla webappu obsługującego kilkadziesiąt tasków, ale od kiedy to ustawiłem, nie miałem ani jednego crasha OOM. Wcześniej zdarzały się mniej więcej raz w tygodniu podczas deploymentu.
Problem z Docker socket
Supervisor Trigger.dev musi rozmawiać z Dockerem, żeby uruchamiać runnery tasków. Naiwne podejście to bezpośrednie zamontowanie socketa:
| |
To daje kontenerowi pełny dostęp do Dockera, co oznacza, że może zrobić cokolwiek na hoście. Dla procesu wykonującego dowolny kod użytkownika to problem.
Lepsze podejście to socket proxy. tecnativa/docker-socket-proxy siedzi między supervisorem a właściwym socketem, a ty konfigurujesz, do których endpointów API może dotrzeć:
| |
Supervisor łączy się z proxy zamiast bezpośrednio z socketem. Nadal może to, co musi, ale promień rażenia jest mniejszy.
Bootstrap mode i worker token
Jeden szczegół setupu Trigger.dev v4, który nie jest oczywisty z dokumentacji: webapp potrzebuje worker tokenu, żeby przyjmować połączenia od supervisora. W deploymencie w chmurze generujesz go ręcznie. W self-hostedzie bootstrap mode robi to automatycznie.
Wzorzec to wspólny wolumin Docker między webappem i supervisorem. Webapp zapisuje token do pliku przy starcie, supervisor go odczytuje. Brak ręcznego generowania tokenów, brak problemu z kurą i jajkiem przy pierwszym deploymencie.
| |
Lokalny registry
Kod tasków jest budowany w obrazy Docker. Te obrazy muszą gdzieś trafić. Opcje to zdalny registry (Docker Hub, GHCR) albo lokalny. Używam lokalnego registry na porcie 5000.
| |
Webapp i supervisor wskazują na localhost:5000. Nie ma opóźnień na push/pull i deploymenty nie potrzebują zewnętrznego dostępu do sieci. Rozwiązuje też problemy z cross-arch registry, bo build i runtime to ta sama maszyna.
Deployment tasków
Pipeline deploymentu to workflow GitHub Actions. Self-hosted runner jest na tej samej płytce co wszystko inne, więc buduje i deployuje natywnie na ARM64.
| |
trigger.config.ts używa rozszerzenia aptGet dla zależności systemowych i syncEnvVars do pobierania sekretów ze środowiska przy deploymencie. Jak komendy devopsowe wchodzą w interakcję z tym setupem opisałem w poście o komendach devopsowych. Zarówno /deploy, jak i /trigger-status owijają ten workflow.
Co tak naprawdę na tym działa
Aktualnie 16 tasków. Kilka to praktyczna automatyzacja:
foxess-pvoutput: synchronizuje dane z paneli słonecznych do PVOutput co 5 minutservicenow-daemon: odpytuje instancję ServiceNow o nowe incydentycheck-appointments: monitoruje rządowy serwis rezerwacji o wolne terminy, z rozwiązywaniem CAPTCHA przez Browserless- Taski do komunikacji ze szkołą przez Librus (
send-excuse,send-teacher-message)
Reszta to automatyzacja bloga. generate-cover wywołuje Gemini API, żeby generować okładki. news-digest agreguje wiadomości o AI w tygodniowe podsumowanie. notify-publish wysyła powiadomienie na kanał Telegram, gdy pojawia się nowy wpis. Post jak ten blog działa sam ma więcej szczegółów o tych taskach.
Co zrobiłbym inaczej
Uruchamianie 11 kontenerów na 7,4 GB obok wszystkiego innego jest wykonalne, ale zostawia mało miejsca na cokolwiek nowego. ClickHouse jest głównym ograniczeniem. Gdybym zaczynał od nowa, sprawdziłbym, czy Trigger.dev obsługuje alternatywny backend do metryk albo czy ClickHouse można przenieść na maszynę z większą ilością RAM.
Strona ARM64 działała bez problemów. Obrazy multi-arch działają, a running runner na tej samej płytce oznacza, że nigdy nie muszę myśleć o cross-kompilacji. To wyszło lepiej, niż się spodziewałem.
Jedna rzecz, której nie rozwiązałem: retencja logów. ClickHouse domyślnie przechowuje historię uruchomień w nieskończoność. Powinienem ustawić politykę retencji zanim NVMe się zapełni. To problem dla mnie z przyszłości.