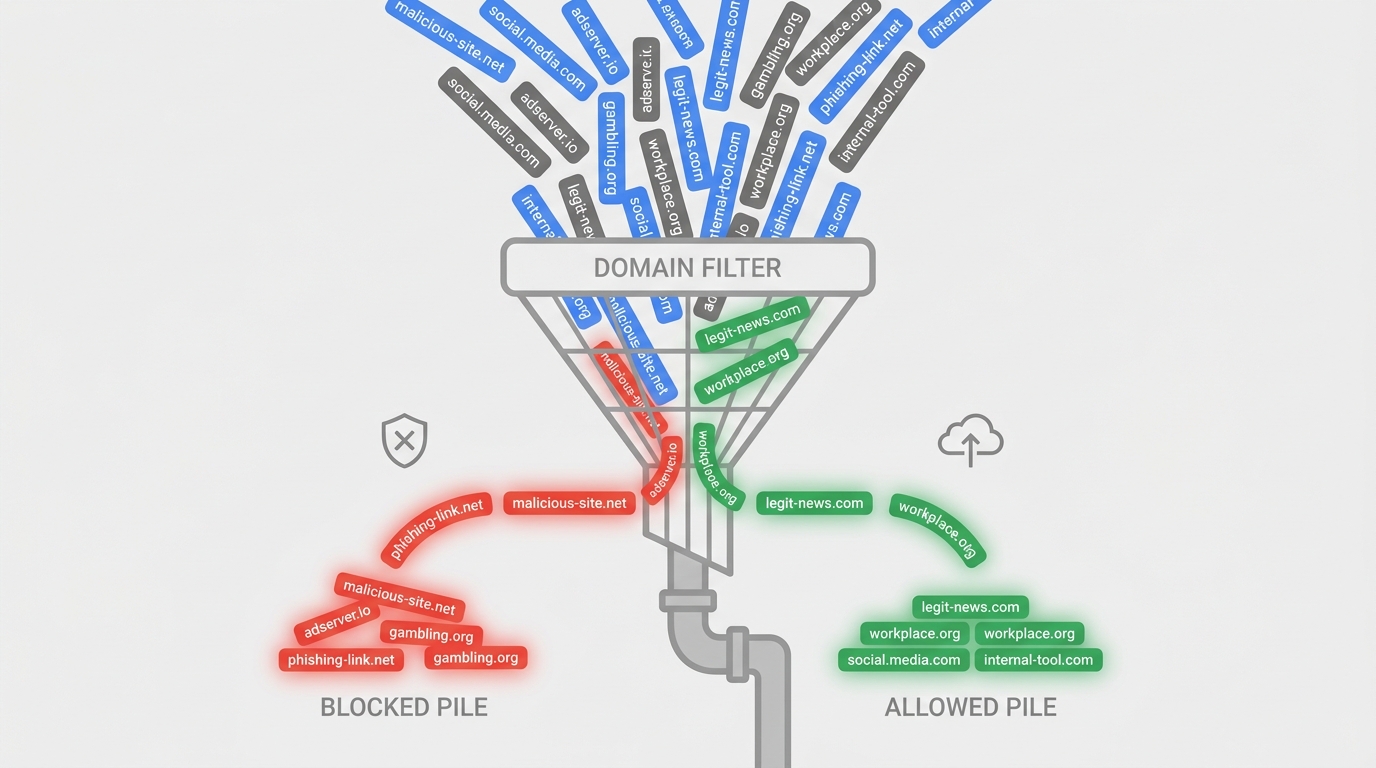
Każdy ad blocker prędzej czy później dzieli się na dwie kupki: domeny, które już zdążyłeś zablokować, i stały strumień nowych, których jeszcze nikt nie sklasyfikował. U mnie w domu DNS-owe blokowanie reklam robi AdGuard Home, a ruch przeglądarki, którego DNS nie łapie, idzie przez privoxy. Oba korzystają ze statycznych blocklist, które aktualizują się na własnym harmonogramie i z założenia są spóźnione względem rzeczywistości. Nowe subdomeny trackerów pojawiają się co tydzień i dopóki sam ich nie dodam, po prostu działają.
Przez jakiś czas mój proces wyglądał tak: zauważam, że coś jest zalane reklamami, otwieram query log, mrużę oczy nad listą domen i ręcznie decyduję, które to trackery, a które to CDN, od którego zależy jakaś prawdziwa strona. To fatalny sposób na spędzenie niedzielnego wieczoru. Napisałem więc dwa małe skrypty, które mrużą oczy za mnie, na harmonogramie, korzystając z LLM jako sędziego zamiast moich własnych.
Problem z blocklistami, w skrócie
Statyczne blocklisty, w formacie zbliżonym do pliku hosts, na których żywią się zarówno AdGuard Home, jak i privoxy, dobrze łapią znanych sprawców i słabo łapią sprawców z tego tygodnia. Nowa subdomena analityczna albo przemianowany tracker mogą siedzieć niezablokowane tygodniami, zanim ktoś to zauważy i zgłosi wyżej. Można żyć z tą luką, albo zbudować coś, co obserwuje własny ruch i oznacza to, czego publiczne listy jeszcze nie dogoniły. Wybrałem tę drugą opcję, głównie dlatego, że “obserwować własny ruch” okazało się jednym popołudniem pisania w Pythonie, gdzie samo pisanie kodu wykonywał Claude Code, a ja decydowałem, jak mają wyglądać reguły.
Co właściwie robi klasyfikator
Oba skrypty, privoxy-ad-classifier.py i adguard-ad-classifier.py, mają tę samą strukturę: pobierają domeny widziane od ostatniego uruchomienia, odrzucają te już zablokowane albo już ocenione, a resztę przekazują do małego CLI, które już wcześniej miałem pod ręką i które nazywa się jevify. Podajesz jevify warunek tak/nie i na wejściu (stdin) rzecz do oceny. Program kończy działanie z kodem 0 dla “tak”, 1 dla “nie”, 3 dla “nie wiadomo”, a w tle stoi LLM. Warunek jest sformułowany celowo precyzyjnie: czy ta konkretna nazwa hosta sama w sobie służy bezpośrednio do serwowania reklam albo pikseli/beaconów śledzących, w odróżnieniu od bycia ogólną domeną firmy czy produktu. To rozróżnienie ma znaczenie. Strona marketingowa dostawcy trackera i jego faktyczna subdomena serwująca piksele mogą dzielić tę samą domenę nadrzędną, a zasługuje na banicję tylko jedna z nich.
Wyniki trafiają do lokalnych plików stanu, nie do niczego działającego na żywo. Werdykt “tak” dopisuje domenę do logu kandydatów, który przeglądam później. “Nie” trafia do cache’u, więc domena nie jest już pytana ponownie. “Nie wiadomo” ląduje w osobnym logu, który sprawdzam oddzielnie. Nic nie jest automatycznie zapisywane do reguł AdGuard Home ani do pliku akcji privoxy. To celowa decyzja, nie przeoczenie: błędnie zablokowana domena pozostaje niewidoczna, dopóki coś się nie zepsuje, a wolę przejrzeć kilkanaście kandydatów przy kawie, niż debugować za trzy tygodnie, dlaczego jakiś formularz po cichu nie chciał się wysłać.
Dwa źródła, dwa zupełnie inne kształty logów
Privoxy i AdGuard Home każą się napracować po te dane na zupełnie różne sposoby. Privoxy daje ci płaski plik logu i nic więcej, więc skrypt trzyma offset w bajtach, czyta to, co nowe od ostatniego razu, i przepuszcza to przez parę wyrażeń regularnych na liniach Request: i Crunch: Blocked:, żeby oddzielić domeny żądane od już zablokowanych. AdGuard Home jest bardziej przyjazny: ma prawdziwe API query logu, więc skrypt się loguje, pobiera najnowszą paczkę wpisów przez HTTP i zapamiętuje znacznik czasu zamiast offsetu w bajtach. Ta sama logika, ta sama lista wykluczeń, te same pliki cache, tylko inna warstwa hydrauliki pod spodem, bo te dwa narzędzia nigdy nie miały się ze sobą w niczym zgadzać.
Lista wykluczeń liczy się bardziej niż sam klasyfikator
Zanim jakakolwiek domena w ogóle trafi do LLM, jest sprawdzana wobec zaszytej na sztywno listy rzeczy, które nigdy nie są oceniane ani blokowane, kropka: infrastruktura VPN i bezpieczeństwa, od której zależę w innych sprawach, domena samego dostawcy AI, zakresy sieci lokalnej i kilka domowych oraz szkolnych portali, które absolutnie nie mogą paść, bo klasyfikator akurat miał gorszy dzień. Ta lista nie jest czymś, co klasyfikator może nadpisać, i nie jest czymś, co chcę, żeby LLM w ogóle zgadywał. Pomyłka na domenie reklamowej kosztuje cię odrobinę mniej irytujący banner. Pomyłka na końcówce VPN kosztuje naprawdę zagmatwaną sobotę, a czasem i telefon.
Jest coś zabawnego w tym, że na sztywno wpisuję domenę własnego dostawcy AI na listę rzeczy, których mój wspomagany przez AI klasyfikator nigdy nie może dotknąć, ale to dokładnie ten typ przypadku brzegowego, w którym pięciominutowa lista bije jakąkolwiek sprytną heurystykę.
Cache, czyli cnota nie pytania dwa razy
Każda oceniona domena ląduje w pliku cache dla “tak” albo dla “nie”, i oba są sprawdzane, zanim cokolwiek w ogóle trafi do LLM. To nie chodzi tylko o koszt zapytań API, choć to też ma znaczenie. Dzięki temu domena oceniona jako “nie” miesiąc temu nie wraca do mojej kolejki przeglądu codziennie tylko dlatego, że wciąż pojawia się w logach. Bez cache’u codzienny log kandydatów byłby zdominowany przez tę samą garstkę legalnych, ruchliwych domen pytanych w nieskończoność, a ja w końcu zacząłbym ignorować całość z czystego zmęczenia. Klasyfikator, którego nikt nie czyta, jest gorszy niż brak klasyfikatora.
Uruchamianie w trybie dry-run, na harmonogramie
Oba skrypty są spięte jako usługa systemd typu oneshot plus dzienny timer z losowym opóźnieniem, żeby nie odpalały się dokładnie o północy i nie młóciły logów jednocześnie. Traktuję “dry-run” jako stałą decyzję projektową, a nie tymczasowy krok przed jakąś większą automatyzacją. Wynik to krótka, nudna lista, którą sprawdzam co kilka dni: zwykle nic, czasem dwie albo trzy naprawdę oczywiste domeny trackerów, które sam dopisuję do statycznej blocklisty. Nie chodziło o to, żeby całkowicie wyjąć się z pętli decyzyjnej. Chodziło o to, żeby przestać być tym, kto musi jako pierwszy zauważyć daną domenę.
Co wciąż jest niedopracowane
Kubełek “nie wiadomo” istnieje, bo binarne tak/nie nie zawsze pasuje do rzeczywistości, i jeszcze nie zdecydowałem, co z nim zrobić poza sporadycznym przeglądaniem. Na razie nie jest na tyle duży, żeby irytować, co może po prostu oznaczać, że nie trafiłem jeszcze na ciekawe przypadki brzegowe. A kody wyjścia 0, 1 i 3 jako publiczny interfejs dla tak, nie i może, za pół roku zmylą mnie samego, bo zapomnę, dlaczego brakuje dwójki. Przyszły ja może to poprawić. Obecny ja miał blocklistę do naprawienia i niedzielę do odzyskania.