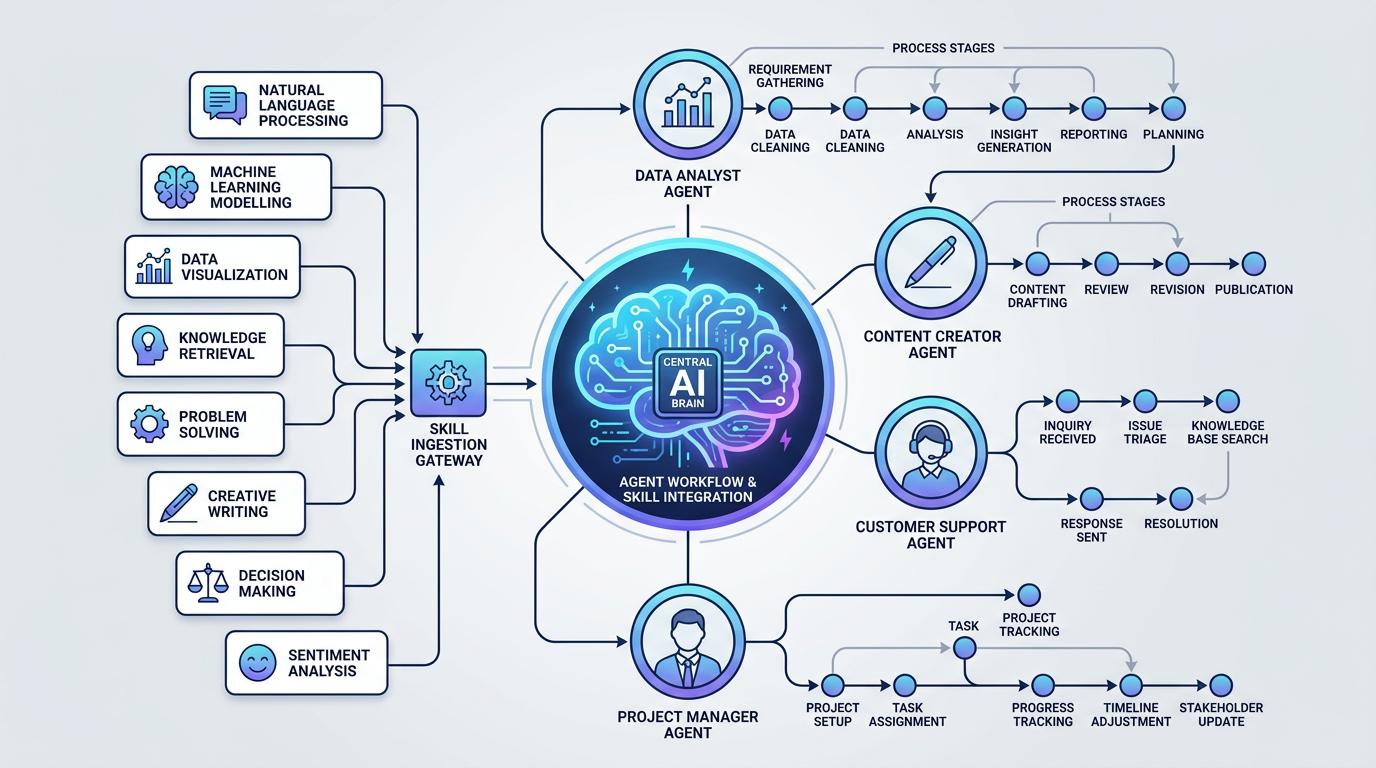
Post o hookach opisywał warstwę bezpieczeństwa, te części, które działają w tle i blokują rzeczy. Ten post jest o drugiej stronie: co się dzieje, gdy chcesz żeby Claude robił więcej, a nie mniej. Konkretnie, jak skills i agenty pozwalają budować wielokrotnego użytku przepływy pracy zamiast powtarzać się co sesję.
Skills kontra commands: ważna różnica
Zanim przejdę do mechaniki, warto wyjaśnić, czym skills nie są. Pisałem wcześniej o własnych komendach: /deploy, /morning, /humanize. Commands to rzeczy, które wpisujesz. Wywołujesz je świadomie.
Skills są inne. Mieszkają w .claude/skills/ i Claude ładuje je automatycznie na podstawie warunków wyzwalania. Nie przywołujesz ich sam. Aktywują się, gdy sytuacja pasuje.
Projekt ma sześć skills:
| |
Na poziomie użytkownika (~/.claude/skills/) jest ich jeszcze kilka, łącznie z jedną o nazwie claudeception, która uczy Claude jak budować lepsze skills. Ta jest w sposób, który doceniam, samozwrotna.
Jak wygląda plik skill
Skill to plik markdown z blokiem YAML frontmatter i treścią instrukcji. Frontmatter mówi Claude kiedy go załadować i jakich narzędzi może używać. Treść to właściwy przepływ pracy.
Oto skill text-humanizer:
| |
Pole description to to, co Claude czyta, żeby zdecydować czy skill jest istotny. Jeśli padnie słowo “delve” albo poprosisz żeby tekst brzmiał naturalnie, skill się ładuje. Jeśli piszesz kod i nigdy nie wspominasz o jakości tekstu, nie ładuje się.
Skill devops-diagnosis jest bardziej rozbudowany. Jego opis zawiera konkretne warunki wyzwalania: logi błędów, stack traces, OutOfMemoryError, connection timeouts, “the app is down”, wyjątki Javy, tracebacki Pythona. Gdy którykolwiek z nich się pojawi, skill ładuje pełny multi-agent pipeline:
- Sprawdź Confluence pod kątem istniejących rozwiązań
- Uruchom równolegle web research, szukanie dokumentacji i przeszukiwanie kodu
- Przekaż wszystkie wyniki do
enterprise-app-specialistw celu analizy przyczyn - Zapytaj użytkownika gdzie udokumentować wyniki
- Wygeneruj podsumowanie ticketu
To jest treść skilla, i uruchamia się za każdym razem gdy te warunki są spełnione, bez konieczności pamiętania żeby go wywołać. Różnica między “wklejam błąd” a “wklejam błąd i Claude automatycznie zaczyna ustrukturyzowane dochodzenie” to właśnie ten jeden plik.
Strategia rozumowania jest też wbudowana. devops-diagnosis używa cot (chain-of-thought), co oznacza, że Claude przechodzi przez każdy krok diagnostyczny sekwencyjnie i pokazuje swoje rozumowanie. pr-reviewer używa self-refine, robi wstępną recenzję, a potem drugi przebieg żeby wyłapać to, co pominął. text-humanizer używa reflexion: draft, krytyka, poprawka.
Agenty: oddzielne okna kontekstu z własnymi regułami
Agenty to inna sprawa. Skill ładuje instrukcje do bieżącej rozmowy. Agent to subprocess z własnym oknem kontekstu, własnymi uprawnieniami do narzędzi i własnym modelem.
Projekt ma ich aktualnie 19:
| |
Wybór modelu jest istotny i celowy. Większość agentów używa sonnet: szybki, sprawny, nie jest przerostem formy nad treścią do dobrze zdefiniowanych zadań. Dwa używają opus: enterprise-app-specialist (głębokie rozumowanie nad złożonymi problemami infrastrukturalnymi) i team-lead (orchestrowanie wielu agentów i synteza ich wyników). Opus wszędzie byłoby wolniejsze. Sonnet wszędzie dałoby gorsze wyniki przy trudnych problemach diagnostycznych.
Każdy plik agenta ma też frontmatter:
| |
Limit maxTurns zapobiega niekontrolowanemu wzrostowi kontekstu. Hook na poziomie agenta oznacza, że kontrole bezpieczeństwa działają nawet wewnątrz subprocessu. Opis, podobnie jak w skilla, to to, co Claude czyta żeby zdecydować czy użyć tego agenta.
Dlaczego izolowane okno kontekstu jest ważne
Głównym powodem delegowania do agentów nie jest zdolność, lecz czystość. Pliki logów są duże. Wyniki wyszukiwania są zaszumione. Jeśli poproszę Claude o analizę pliku logu z 50 000 linii w głównej rozmowie, ten kontekst przepada. Rozmowa zwalnia, a jakość kolejnych odpowiedzi spada.
Gdy deleguję do log-analyzer, uruchamia się we własnym oknie kontekstu, ładuje log, robi robotę i zwraca ustrukturyzowane podsumowanie. Główna rozmowa dostaje trzy akapity wyników, nie pięćdziesiąt tysięcy linii tekstu.
Tak samo z web-researcher. Robi przeszukiwania przez Tavily, filtruje szum i zwraca to, co istotne. Moja główna rozmowa nie gromadzi śmieci z wyszukiwarek.
Agent codebase-investigator robi to samo dla przeszukiwania kodu źródłowego. Jeśli trzeba znaleźć wszystkie użycia klasy w dużym projekcie, to sporo wyjścia z grepa. Agent to ogarnia, ja dostaję podsumowanie.
Teamy agentów i orchestracja
Agent team-lead to miejsce gdzie robi się ciekawie. Używa narzędzia Task do uruchamiania innych agentów i ich koordynowania.
Oto wzorzec incident response z jego pliku:
| |
Kroki 1-4 działają równolegle, bo od siebie nie zależą. Krok 5 działa potem, bo potrzebuje wyników z pierwszych czterech. Team-lead syntezuje wszystko na końcu, nie konkatenując po prostu outputów, ale szukając korelacji między tym, co znalazł każdy agent. Log pokazujący connection timeouts w tym samym czasie co ticket Jira o zmianie sieciowej to inny sygnał niż każde z nich osobno.
Wzorzec pełnego audytu systemu uruchamia trzy agenty równolegle (zdrowie deployów, audyt sekretów, aktualność dokumentacji) i produkuje ujednolicony raport. Uruchamiam to od czasu do czasu, i to najbliższy ekwiwalent daily standup z zespołem, który nie potrzebuje spania.
Praktyczne wzorce
Kilka rzeczy, które warto robić:
Trzymaj skills skoncentrowane. Skill z dwudziestoma warunkami wyzwalania ładuje się kiedy nie powinien, a instrukcje konkurują z bieżącym zadaniem. text-humanizer ma jedno zadanie. devops-diagnosis ma jeden pipeline. Gdy skill próbuje pokryć zbyt wiele, staje się szumem.
Dopasuj model do zadania, nie do ego. Kuszące jest użycie opus wszędzie bo jest lepszy. Ale email-writer na sonnet jest ok. Maile nie wymagają głębokiego rozumowania. enterprise-app-specialist na opus jest warte swojej ceny, bo produkcyjna diagnostyka na RHEL jest naprawdę trudna i jakość modelu widać.
Agent do brudnej roboty, główna rozmowa do decyzji. Nie proszę Claude o analizę logów bezpośrednio w chatie. Nie robię web research w głównym kontekście. Wszystko, co produkuje dużo surowego outputu, idzie do agenta. To, co wraca, to zawsze podsumowanie.
Skills jako pamięć instytucjonalna. Skill lapa-azure-admin zawiera wszystko specyficzne dla środowiska Azure jednego klienta: tenant ID, strukturę subskrypcji, konwencje nazewnicze, które reguły firewalla są istotne. Bez tego skilla musiałbym na nowo tłumaczyć środowisko co sesję. Z nim Claude już to wie.
Powiązane: Moje środowisko Claude Code | Własne komendy | Hooki i system uprawnień