Claude Code nie ma pamięci między sesjami. Każda rozmowa zaczyna się od zera. Jeśli w zeszły czwartek naprawiłem konkretny problem z deploymentem, wymyśliłem właściwe flagi ffmpeg do jakiegoś zadania albo udokumentowałem trudny przypadek z PostgreSQL, ta wiedza znika w momencie zamknięcia sesji, chyba że gdzieś to zapisałem. Okno kontekstu też jest skończone. Nie mogę wklejać trzech miesięcy notatek do każdej rozmowy.
Oczywiste rozwiązanie to wyszukiwanie. Dać asystentowi możliwość przeszukania bazy wiedzy i zaciągnięcia odpowiedniego kontekstu na żądanie. Właśnie to robi RAG. Zbudowałem taki system.
Dlaczego nie gotowe rozwiązanie w chmurze
Są hostowane bazy wektorowe i produkty RAG-as-a-service. Zacząłem od Supabase do przechowywania wektorów. Działa, ale dodaje zewnętrzną zależność i opóźnienie sieciowe do każdego zapytania. Wszystko, co indeksuję, to dane wewnętrzne: moje notatki, podsumowania sesji, runbooki, dokumentacja infrastruktury. Wysyłanie tego do zewnętrznego serwisu brzmi źle. Lokalny pgvector nie ma zewnętrznych zależności, jest szybszy dla rozmiarów zapytań, z którymi pracuję, nic nie kosztuje i mogę go pg_dumpować do backupu na NAS. Łatwy wybór.
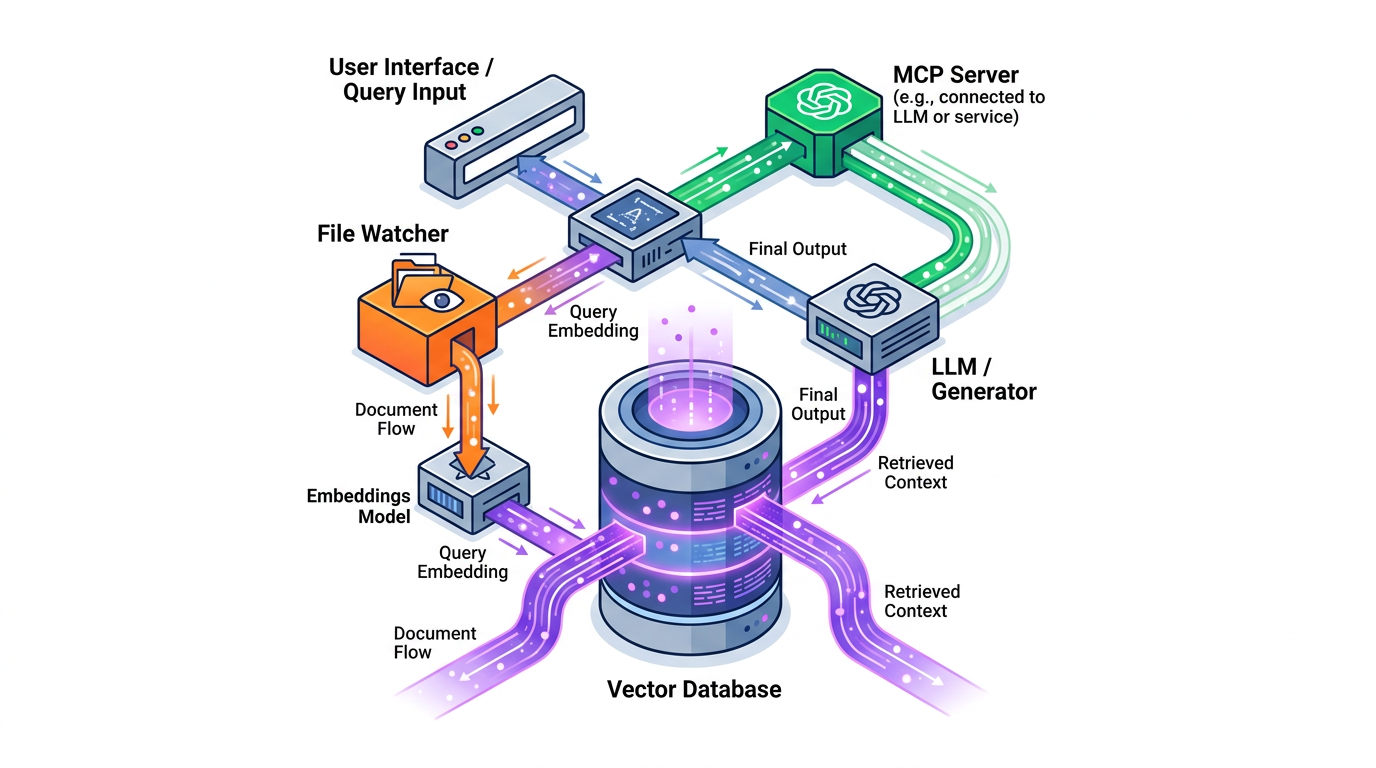
Architektura
Cztery kontenery Docker, jeden plik Compose.
graph TD
    NAS["/mnt/nas + pliki pamięci"] -->|"nowe/zmienione pliki"| W["rag-watcher
watchdog service"]
    W -->|"ingest + embed"| DB["rag-pgvector
pgvector + HNSW"]
    DB -->|"similarity search"| APP["multimodal-rag
Gradio web UI
port 7860"]
    DB -->|"similarity search"| MCP["rag-mcp
Gradio MCP server
port 7861 localhost"]
    APP -->|"uwierzytelnianie"| CF["tunel Cloudflare
rag.tomakl.dev"]
    MCP -->|"narzędzie rag_search"| CC["Claude Code
.mcp.json"]
    GEM["Gemini Embedding 2
1536 wymiarów, multimodal"] -.->|"embed tekst/obraz/wideo"| W
    GEM -.->|"embed zapytanie"| APP
    GEM -.->|"embed zapytanie"| MCP

    style DB fill:#f3e5f5,stroke:#6a1b9a
    style MCP fill:#c8e6c9,stroke:#2e7d32
    style APP fill:#e3f2fd,stroke:#1565c0
    style CC fill:#e3f2fd,stroke:#1565c0
    style W fill:#fff3e0,stroke:#e65100
Watcher monitoruje /mnt/nas/ i katalog z plikami pamięci. Kiedy plik zostanie dodany lub zmieniony, ingestuje jego treść, generuje embedding przez Gemini i zapisuje go w pgvector. Aplikacja webowa i serwer MCP korzystają z tej samej bazy danych.
Wybór modelu embedingów
Gemini Embedding 2 jest multimodalny. Jeden model obsługuje tekst, obrazy i wideo, a wszystkie lądują w tej samej przestrzeni wektorowej. Zapytanie tekstowe może więc znaleźć obraz, który semantycznie do niego pasuje, i odwrotnie. Nie ma oddzielnego enkodera wizji ani oddzielnego enkodera tekstu z jakąś warstwą wyrównania przyklejoną z boku. Jedna przestrzeń embeddingów.
Dla wideo model ma limit 128 sekund na segment. Dzielę na 97-sekundowe fragmenty z 15-sekundowym nakładaniem przy użyciu ffmpeg przed embeddingiem. Nakładanie oznacza, że scena znajdująca się na granicy fragmentu i tak zostanie uchwycona.
Darmowy tier to 1000 embeddingów dziennie. Przy moim wolumenie indeksowania (około 170 dokumentów) i częstotliwości zapytań nigdy nie trafiłem w ten limit.
Sztuczka z MCP
Aplikacja webowa ma ochronę hasłem. To ok dla przeglądarki, ale nie dla narzędzia MCP. Klient HTTP MCP w Claude Code nie potrafi się uwierzytelnić.
Rozwiązanie: dwie instancje Gradio. Jedna to pełna aplikacja na porcie 7860, za uwierzytelnianiem, wystawiona przez Cloudflare. Druga to minimalna instancja na porcie 7861, tylko localhost, bez uwierzytelniania, z włączonym trybem serwera MCP.
| |
Serwis Docker Compose binduje się tylko do localhost:
| |
I wpis w .mcp.json:
| |
Claude Code pobiera to przy starcie. Narzędzie mcp__rag__rag_search jest trwale dozwolone w ustawieniach, więc nigdy nie pojawia się prompt z pytaniem o uprawnienia. Opisałem, kiedy go używać, w pliku reguł: wewnętrzna infrastruktura, poprzednie sesje, wszystko co zaczyna się od “czy pamiętasz…”.
Zapobieganie duplikatom dokumentów
Pliki są ponownie ingestowane przy każdej zmianie. Watcher widzi zdarzenie modyfikacji i wywołuje funkcję ingestowania jeszcze raz. Bez strategii deduplikacji każda edycja dodawałaby kolejny wiersz.
Wzorzec, którego używam: usuń według ścieżki pliku źródłowego, potem wstaw.
| |
Dla podzielonych plików (jak długie PDF-y albo segmenty wideo) wszystkie fragmenty mają ten sam source_file. DELETE usuwa je wszystkie, potem INSERT dodaje świeży zestaw. Wystarczająco atomowe na moje potrzeby.
Auto-ingestowanie i watcher
Watcher to serwis Python używający Watchdog. Monitoruje dwa katalogi: /mnt/nas/ (dokumenty, notatki, runbooki, wyeksportowane dane) i katalog plików pamięci. Kiedy Watchdog wywołuje FileModifiedEvent lub FileCreatedEvent, serwis uruchamia pipeline ingestowania.
Zapisuję też podsumowania sesji na koniec każdej sesji Claude Code. Plik ląduje w katalogu pamięci, Watchdog go odbiera i zostaje zembeddowany. W następnej sesji odpowiednie zapytanie wyciągnie to podsumowanie. To nie jest perfekcyjne przypominanie. To wystarczająco dobre przypominanie, czego mi trzeba.
Tabela sessions przechowuje też znaczniki czasu i metadane. Przy wyszukiwaniu widzę, z którego pliku źródłowego pochodzi wynik i kiedy był indeksowany.
Wektory i HNSW
pgvector obsługuje kilka typów indeksów. Używam HNSW (Hierarchical Navigable Small World) zamiast IVFFlat. HNSW buduje wielowarstwowy graf i daje lepszą wydajność zapytań kosztem wolniejszego budowania i większego zużycia pamięci. Dla indeksu 170 dokumentów czas budowania nie jest problemem. Liczy się szybkość zapytań.
| |
Odległość cosinusowa ma sens dla znormalizowanych wektorów embeddingów. Embeddingi Gemini są normalizowane jednostkowo, więc cosinus i iloczyn skalarny są równoważne, ale zostawiam cosinus jawnie.
Jak to wygląda w użyciu
W trakcie sesji Claude Code przeważnie nie myślę o RAG. Plik reguł mówi asystentowi, kiedy go odpytywać, i on to robi. Kiedy wspomnę projekt, którego nie dotykałem od kilku tygodni, zazwyczaj jest moment, gdy system zaciąga odpowiedni runbook albo notatkę z poprzedniej sesji i rozmowa ma właściwy kontekst od samego początku.
Polecenie /rag jest do jawnych wyszukiwań, kiedy chcę znaleźć coś konkretnego. Używam też Gradio web UI od czasu do czasu, żeby przeglądać co jest zaindeksowane albo ręcznie coś wgrać.
Gdzie to kuleje: wyszukiwanie jest tylko tak dobre, jak to co zaindeksowałem. Podsumowania sesji pomagają, ale to ciągle podsumowania. Jeśli nie zapisałem konkretnego polecenia ani dokładnej wartości konfiguracji, nie będzie tego w bazie. To problem z robieniem notatek, nie z RAG.
Liczby
- ~170 zaindeksowanych dokumentów
- Wektory 1536-wymiarowe, indeks HNSW
- 259MB całkowity backup (dokumenty + 20 mirrorów repozytoriów GitHub)
- Gemini Embedding 2, darmowy tier
20 mirrorów repozytoriów GitHub to bonus. Mam dzienny cron, który mirroruje repozytoria, na których mi zależy, na NAS, a watcher ingestuje ich pliki README i dokumentację. Dzięki temu mogę zapytać asystenta o API jakiejś biblioteki i czasem dostać odpowiedź z lokalnych danych zamiast szukać w internecie.
Co zrobiłbym inaczej
Integracja serwera MCP przez Gradio jest wygodna, ale trochę krucha. Obsługa MCP w Gradio jest udokumentowana, ale słabo przetestowana, a kształt API zmienił się między wersjami. Dedykowany serwer MCP na FastAPI byłby bardziej przewidywalny. Pewnie w końcu to zmigruję.
Watcher też ma edge case’y. Jeśli plik jest zapisywany przez kilka atomowych renamingów (co niektóre edytory robią), można dostać dwa zdarzenia ingestowania dla tej samej zmiany. Wzorzec upsert obsługuje duplikację, ale jest krótkie okno, w którym nieaktualne embeddinging może obsłużyć zapytanie. Wystarczające dla notatek i dokumentów. Nie budowałbym na tym produkcyjnego wyszukiwania.
Integracja z Claude Code zajęła może 30 minut po uruchomieniu stosu Docker. Dodaj wpis do .mcp.json, zatwierdzisz narzędzie w ustawieniach, napisz plik reguł kiedy go używać. Hooki i agenci, które miałem już ustawione, sprawiły, że podpięcie tego było proste.