Kilka tygodni temu Anthropic opublikował github.com/anthropics/skills. To zbiór referencyjnych skills dla Claude, obejmujący wszystko od manipulacji dokumentami, przez generowanie serwerów MCP, po szablony komunikacji wewnętrznej. Skills dokumentowe (pdf, docx, xlsx, pptx) to kod faktycznie działający pod spodem wbudowanych funkcji tworzenia plików w Claude. Reszta jest na licencji Apache 2.0.
Bardziej interesujące niż same skills jest to, co repo ujawnia o działaniu systemu. W szczególności skill-creator, który zawiera kompletny iteracyjny workflow z evalami i optymalizatorem opisów. Jeśli dotychczas pisałeś skills w Claude Code na wyczucie, to jest dobry punkt odniesienia do robienia tego bardziej systematycznie.
Co jest w repo
Katalog skills/ zawiera 17 skills podzielonych na kategorie:
Kreatywne i design: algorithmic-art, canvas-design, brand-guidelines, theme-factory, slack-gif-creator
Development i techniczne: mcp-builder, webapp-testing, web-artifacts-builder, frontend-design, claude-api
Korporacyjne i komunikacja: internal-comms, doc-coauthoring
Skills dokumentowe (source-available, nie open source): pdf, docx, xlsx, pptx
Meta-skill: skill-creator
Skills dokumentowe są najbardziej interesujące z punktu widzenia przejrzystości. Anthropic zaznacza, że są “aktywnie używane w produkcyjnej aplikacji AI.” Czytając opis skill pdf widać, że obsługuje ekstrakcję tekstu, OCR, łączenie, podział, wypełnianie formularzy, szyfrowanie i ekstrakcję obrazków. Jedno pole description pokrywa to wszystko. Treść skill pewnie robi robotę, ale to właśnie description decyduje o tym, czy Claude po niego sięgnie.
Jak skills naprawdę działają
Specyfikacja (też w repo, wskazująca na agentskills.io) opisuje trójpoziomowy system ładowania:
- Metadane (name + description): zawsze w kontekście, około 100 słów. To jedyne, co Claude widzi przy podejmowaniu decyzji o uruchomieniu skill.
- Ciało SKILL.md: ładowane do kontekstu gdy skill się uruchomi, najlepiej poniżej 500 linii.
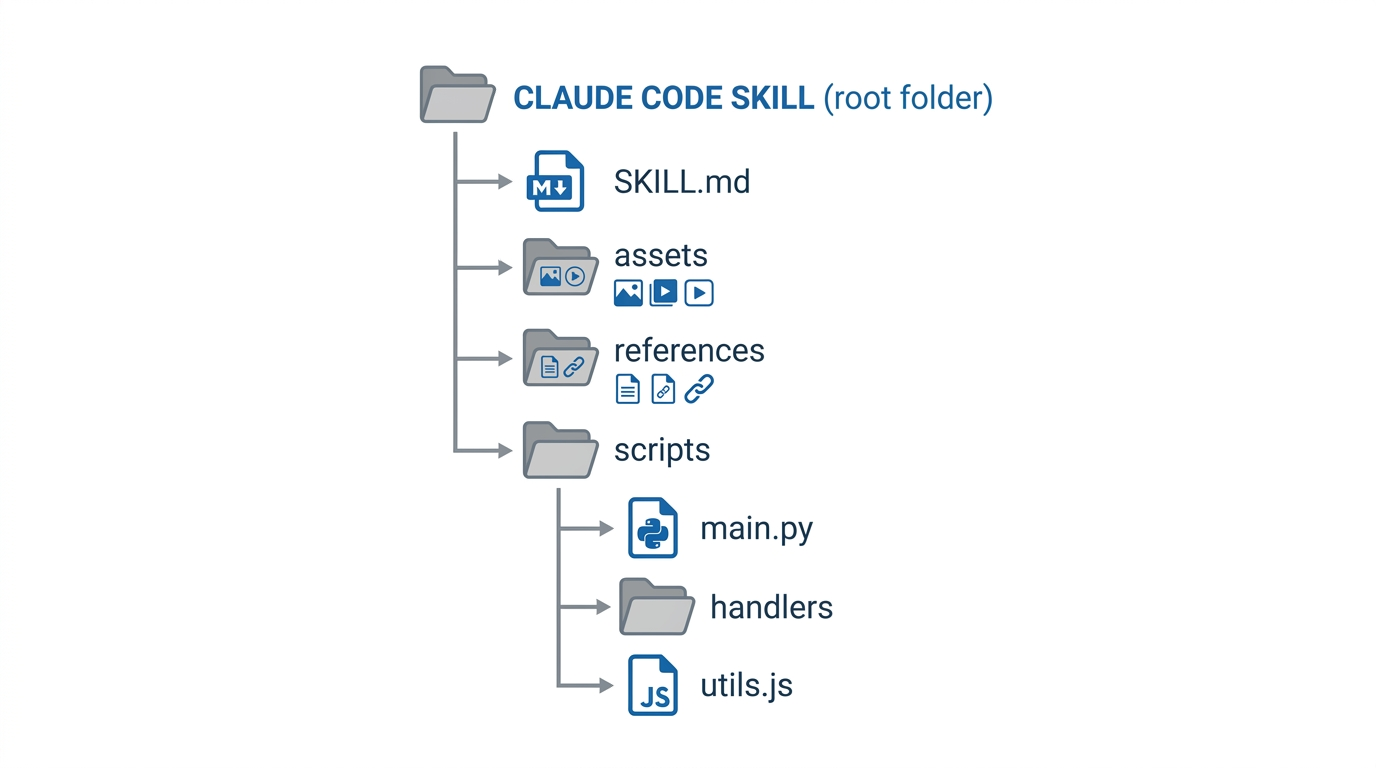
- Dołączone zasoby: scripts, references i assets ładowane na żądanie.
Struktura folderu skill wygląda tak:
| |
Model progressive disclosure pozwala pisać krótki opis i krótkie ciało SKILL.md, a większość treści przenosić do plików referencyjnych. Przewodnik skill-creator zaleca trzymanie SKILL.md poniżej 500 linii i dodawanie spisu treści do każdego pliku referencyjnego powyżej 300 linii.
Jest jeden praktyczny wniosek z poziomu trzeciego: jeśli kilka przebiegów testowych niezależnie pisze ten sam helper script, to sygnał, żeby go dołączyć. Skill-creator guide nazywa to “repeated work across test cases.” Wrzuć skrypt do scripts/, powiedz skillowi żeby go używał, i każde przyszłe wywołanie pomija krok wymyślania koła na nowo.
Pole description to cały mechanizm triggerowania
To jest część, która sprawia problemy. Skills nie triggerują na słowa kluczowe. Claude czyta name i description, po czym decyduje czy użyć skill na podstawie tego, jak dobrze pasuje do bieżącego zadania. Ciało skill nie ma znaczenia dopóki Claude nie zdecyduje już o uruchomieniu.
W SKILL.md skill-creator jest wyraźna uwaga na ten temat:
“Currently Claude has a tendency to ‘undertrigger’ skills – to not use them when they’d be useful. To combat this, please make the skill descriptions a little bit ‘pushy’.”
Podany przykład: zamiast “How to build a simple fast dashboard to display internal data,” napisz “How to build a simple fast dashboard to display internal data. Make sure to use this skill whenever the user mentions dashboards, data visualization, internal metrics, or wants to display any kind of company data, even if they don’t explicitly ask for a ‘dashboard.’”
Ten wzorzec widać w opisie skill pdf: “If the user mentions a .pdf file or asks to produce one, use this skill.” Skill internal-comms dodaje “Claude should use this skill whenever asked to write some sort of internal communications.” Bez owijania w bawełnę.
Repo zawiera też optymalizator opisów, który uruchamia automatyczną pętlę poprawiającą dokładność triggerowania. Generuje 20 zapytań ewaluacyjnych (mix should-trigger i should-not-trigger), dzieli je 60/40 na zbiory train i test, ocenia bieżący opis 3 razy na zapytanie, po czym wywołuje Claude z extended thinking w celu zaproponowania ulepszeń. Działa do 5 iteracji i wybiera najlepszy opis według wyniku na zbiorze testowym, a nie treningowym, żeby uniknąć przeuczenia. Uruchamia się tak:
| |
Workflow skill-creator
Skill-creator to skill do budowania skills. Jest też najdokładniej udokumentowaną częścią repo. Opisany workflow wygląda tak:
- Ustal intencję (co skill ma robić, kiedy triggerować)
- Napisz draft SKILL.md
- Przygotuj 2-3 prompty testowe, uruchom je równolegle ze skillem i bez
- Podczas gdy przebiegi trwają, napisz ilościowe assertions
- Oceń wyniki, zagreguj do benchmarku, otwórz viewer do przeglądu
- Przeczytaj feedback użytkownika, popraw skill, powtórz
- Zoptymalizuj opis
Eval viewer to lokalna aplikacja webowa z dwoma zakładkami: jedną do przeglądania wyników jakościowych obok siebie (ze skillem vs bez, albo nowa vs stara wersja), drugą z benchmarkiem ilościowym. Benchmark pokazuje wskaźniki zdawalności, czas i zużycie tokenów ze średnią i odchyleniem standardowym. Tryb “blind comparison” jest opcjonalny: daje dwa wyniki niezależnemu subagentowi bez oznaczenia, który jest który, i prosi o ocenę jakości. Większość użytkowników tego nie potrzebuje.
Krok grading używa JSON assertions z trzema polami: text (opis co sprawdzić), passed (bool) i evidence (co grader znalazł). Resztą zajmuje się skrypt agregujący benchmark.
Dla skills z subiektywnymi wynikami (styl pisania, design) przewodnik mówi żeby pominąć ilościowe assertions i polegać na przeglądzie ludzkim. To ma sens. Wymuszanie ocen pass/fail na “czy to dobrze wygląda” generuje szum.
Instalacja z repo w Claude Code
| |
Potem przeglądasz i instalujesz document-skills albo example-skills. Albo bezpośrednio:
| |
Po instalacji wystarczy wspomnieć co chcesz zrobić. “Use the PDF skill to extract tables from this file” w zupełności wystarcza. Dokumentacja triggerowania mówi, że proste jednoetapowe prośby mogą nie triggerować skill, bo Claude poradzi sobie sam; złożone zadania wieloetapowe są bardziej niezawodne.
Co to zmienia dla autorów własnych skills
Główna wartość repo dla użytkowników Claude Code to nie poszczególne skills. Większość z nich to dobre referencje, ale i tak byś je dostosował do własnych potrzeb.
Co jest naprawdę przydatne:
Skill-creator daje strukturalną pętlę iteracji. Zamiast “napisz SKILL.md, spróbuj kilka razy, popraw,” masz porządny cykl draft-test-review-improve z metrykami. Jeśli budujesz coś, z czego będziesz korzystać codziennie, dodatkowa precyzja jest warta nakładu.
Optymalizator opisów usuwa zgadywanie. Triggerowanie to najtrudniejsza część projektowania skill. Narzędzie generujące realistyczne zapytania edge-case, uruchamiające je na dużą skalę i proponujące ulepszenia opisów na podstawie tego co zawiodło, oszczędza sporo czasu w porównaniu z ręcznym strojeniem.
Struktura progressive disclosure daje wzorzec dla złożonych skills. Jeśli SKILL.md rośnie powyżej 300 linii, odpowiedzią są prawdopodobnie pliki w references/, a nie więcej tekstu inline.
Rada o “pushy description” jest od razu użyteczna. Nie potrzebujesz narzędzi evalowych, żeby dodać do istniejących skills “Use this skill whenever the user asks about X, even if they don’t explicitly mention Y”. Jeśli skill nie triggeruje niezawodnie, to zwykle jest powód.
Piszę skills od kilku miesięcy, głównie tak jak opisałem w poście o setupie i poście o custom commands. Główna rzecz, którą wezmę z repo, to pętla optymalizacji opisów. Moje obecne opisy działają, ale nie testowałem ich pod kątem zapytań near-miss, a problem “undertriggering” jest realny.
Post o hookach obejmuje stronę uprawnień i bezpieczeństwa Claude Code. Skills to druga połowa: miejsce, gdzie trzymasz wiedzę.